はじめに
株式会社ネクストスケープ Chief Technology Office所属の小野塚です。
前々回はDevin(Devin Desktop)でASP.NET Core MVCのTodoアプリをTDDで実装した記事を、前回はそのPRをDevin Reviewでレビューしてもらった記事を書きました。
今回は同じTodoアプリを題材に、Microsoft製のE2Eテストフレームワーク「Playwright」に組み込まれたAIエージェント機能、Test Agents(https://playwright.dev/docs/test-agents)を試してみます。
Test AgentsはPlaywright 1.56(2025年10月)で登場した機能で、Planner(アプリを探索してテスト計画をMarkdownで作成)、Generator(計画から実際のテストコードを生成)、Healer(失敗したテストを自動で診断・修復)という3つのエージェントで構成されています。
今回検証した時点の最新版はPlaywright 1.62.1(1.62.0が2026年7月24日、パッチの1.62.1が7月30日リリース)で、これまで別途セットアップが必要だったMCPサーバーが npx playwright mcp として本体に標準バンドルされたほか、AIエージェントの作業内容を動画証跡として残す「Agentic video receipts」も追加されるなど、AIとの連携を前提にした強化が続けて入っているタイミングでの検証になりました。
Playwrightのインストール
まずは新規フォルダを作ってPlaywrightプロジェクトを作成します。
npm init playwright@latest対話式でTypeScript/JavaScriptの選択(デフォルトのTypeScriptのまま)、テストフォルダ名、GitHub Actionsワークフローの追加有無(今回は動作確認が目的なので追加せず)、ブラウザのインストール(yes)を聞かれます。
完了すると playwright.config.ts や tests/example.spec.ts などのひな形が生成されます。
念のため付属のサンプルテストを実行し、正常にインストールできているか確認しました。
npx playwright test以下の通り、6件のテストが全てパスしました。
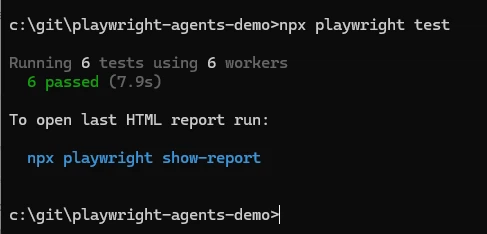
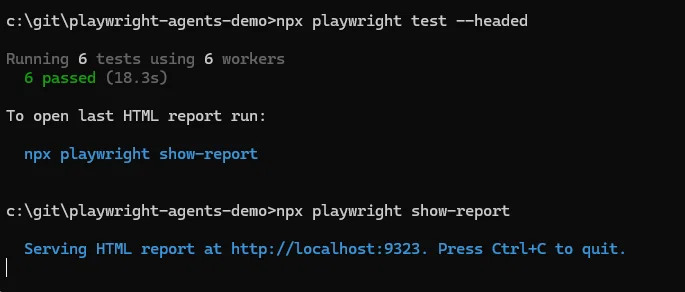
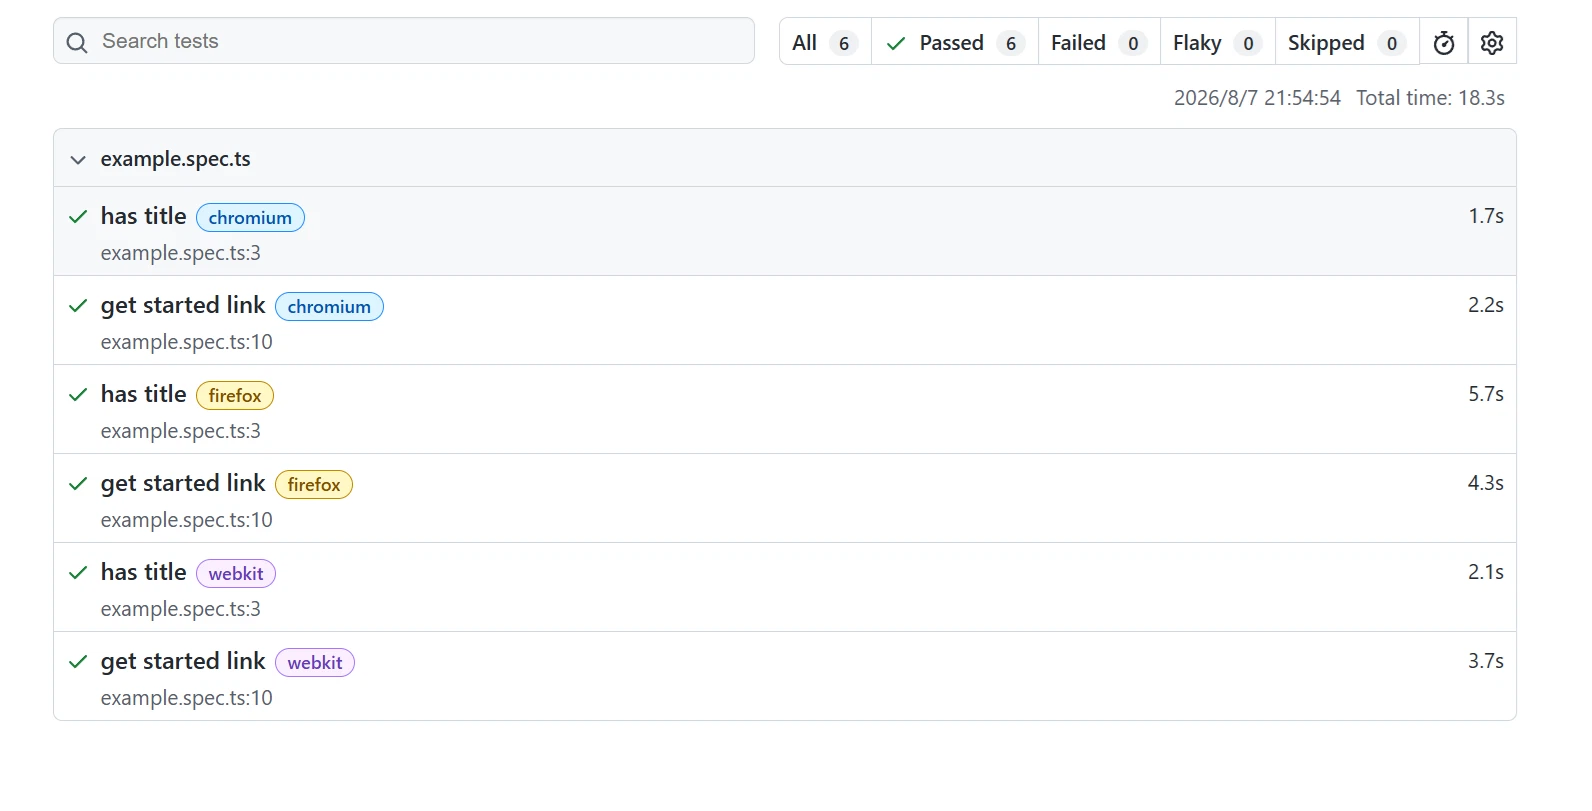
デフォルトはヘッドレス実行(画面を表示せず裏側でブラウザを動かす)のため、ブラウザのウィンドウは表示されません。動きを目視したい場合は --headed オプションを付けます。
Test Agentsの定義を生成する
ここからが本題です。使っているAIツールに応じて init-agents コマンドを実行します。今回はClaude Codeを使うので --loop=claude を指定しました。
npx playwright init-agents --loop=claude実行すると、以下のファイル一式が生成されます。
specs\README.md— テスト計画(Markdown)を置くディレクトリの説明tests\seed.spec.ts— エージェントが最初に実行する、環境セットアップ済みのpageを渡すためのひな形テスト.claude\agents\playwright-test-planner.md— Plannerのエージェント定義.claude\agents\playwright-test-generator.md— Generatorのエージェント定義.claude\agents\playwright-test-healer.md— Healerのエージェント定義.mcp.json— Claude CodeがPlaywrightを操作するためのMCP接続設定
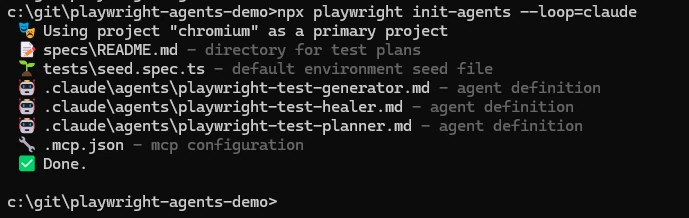
ここで重要なのは、これらの .md ファイルは「Plannerとはこういう役割で、こういう手順で、こういうMCPツールを使え」という指示書(プロンプト)でしかなく、それ自体には実行する力がないという点です。
実際にMCP経由でブラウザを操作したり、ファイルを編集したりする「頭脳」の役目を担うのは、--loopで指定したAIツール(今回はClaude Code)のエージェントループです。つまりPlaywright Test Agents単体では自律動作せず、必ず何らかのAIエージェントの実行ループとセットで初めて機能する、という設計になっています。
Claude CodeでMCPサーバーを許可する
playwright-agents-demo フォルダでClaude Codeを起動すると、生成された .mcp.json を検知して、MCPサーバーの利用可否を確認する画面が出ます。
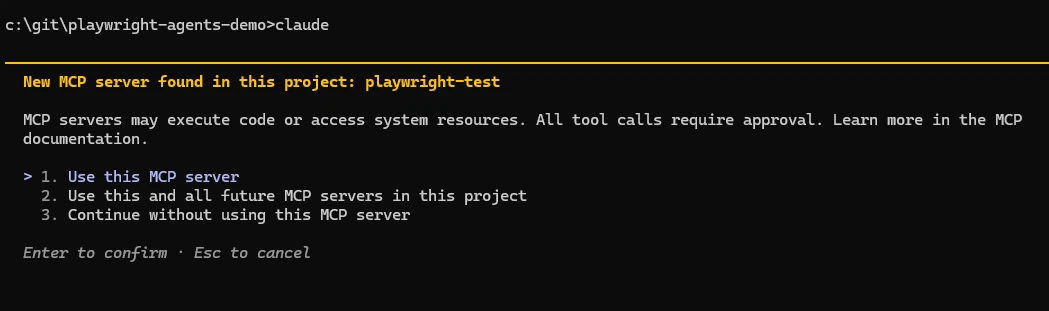
Test AgentsはこのMCPサーバー経由でブラウザを操作するため、許可しないと何も動きません。何度もこのフォルダで作業する予定だったので「2. Use this and all future MCP servers in this project」を選び、以降このプロジェクトでは確認なしで使えるようにしました。
テスト対象を用意する
tests\seed.spec.ts を、前々回・前回の記事で使ったTodoアプリ(http://localhost:5178)を開くだけの内容に書き換えます。
import { test, expect } from '@playwright/test';

test('seed', async ({ page }) => {
  await page.goto('http://localhost:5178');
});
Todoアプリ側は dotnet run で起動しておきます。単体で動作確認してから、次のステップに進みました。
npx playwright test tests/seed.spec.ts --headed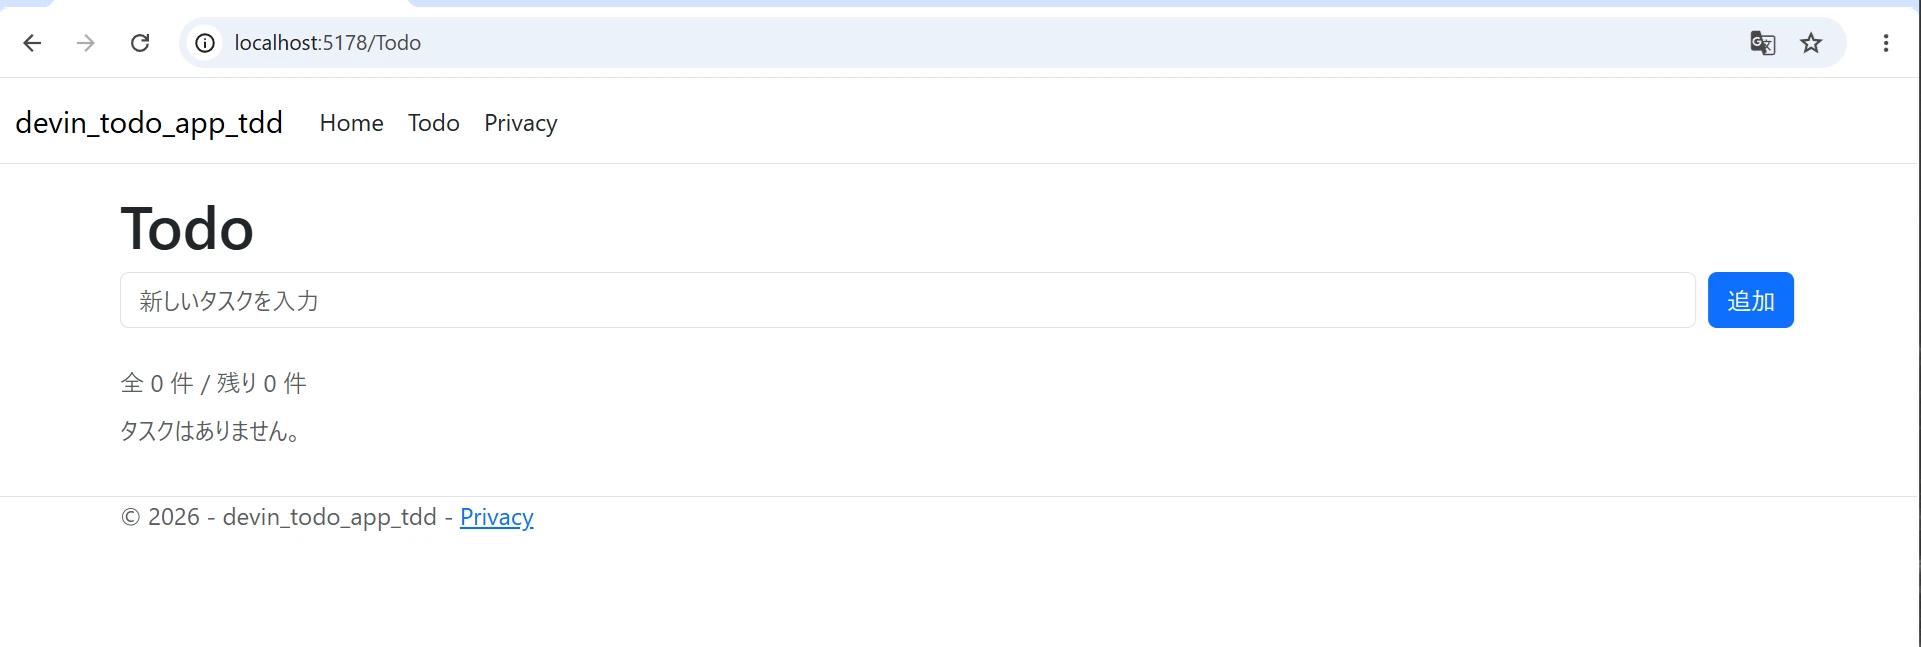
Plannerにテストプランを作らせる
Claude Codeで以下のように依頼しました。
planner を使って、Todoの追加・完了・削除・フィルタ切替のテストプランを作って。seed.spec.ts を使って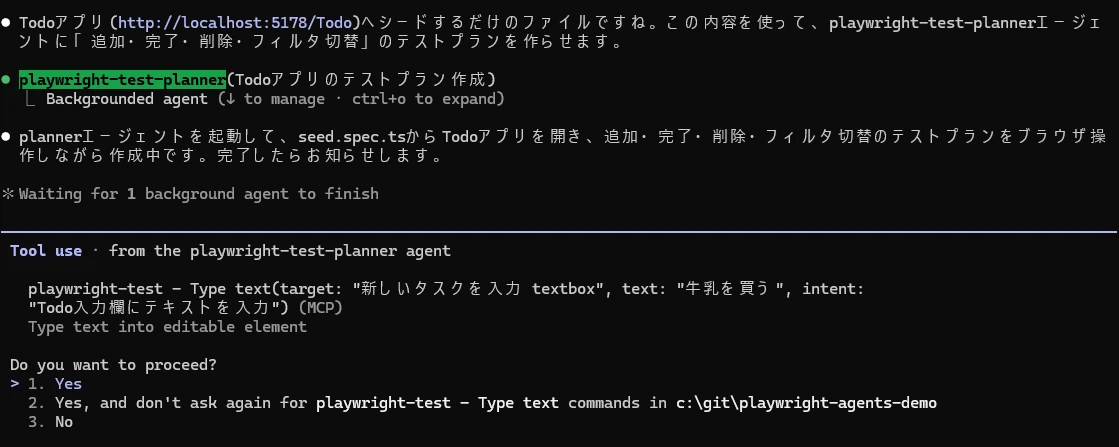
ブラウザも起動され、テスト手順であろう動作が行われています。
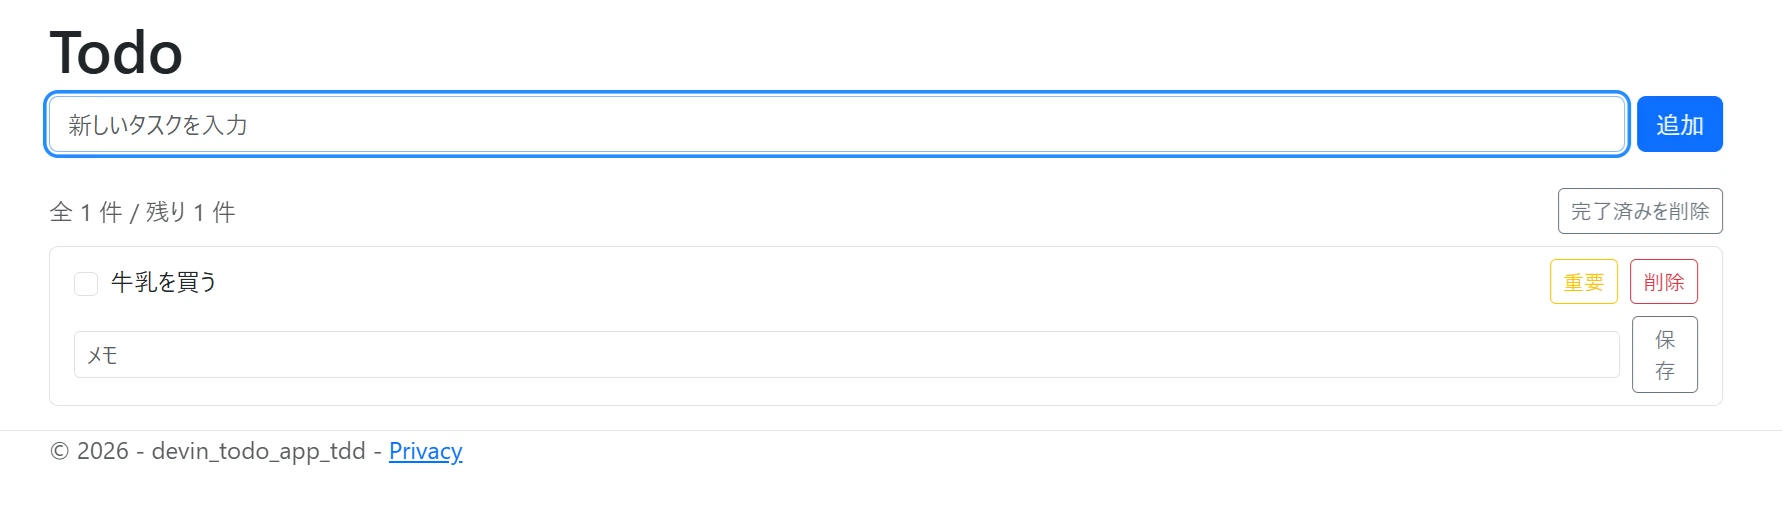
以下、完了した直後の画面です。
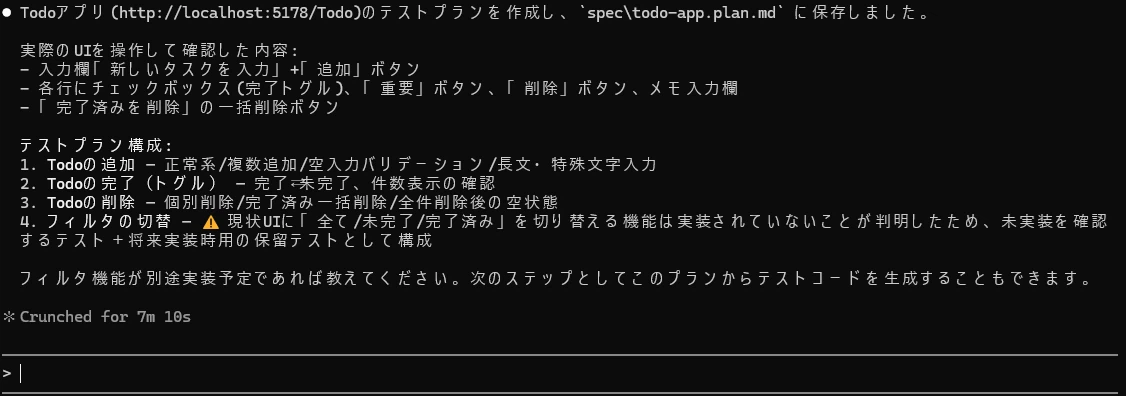
spec\todo-app.plan.md にテスト計画が生成され、実際に操作して確認したUI要素(入力欄、追加ボタン、チェックボックス、削除ボタンなど)と、以下4カテゴリのテスト構成が示されました。todo-app.plan.mdを開いてみると以下のようにテストプランが書かれています。
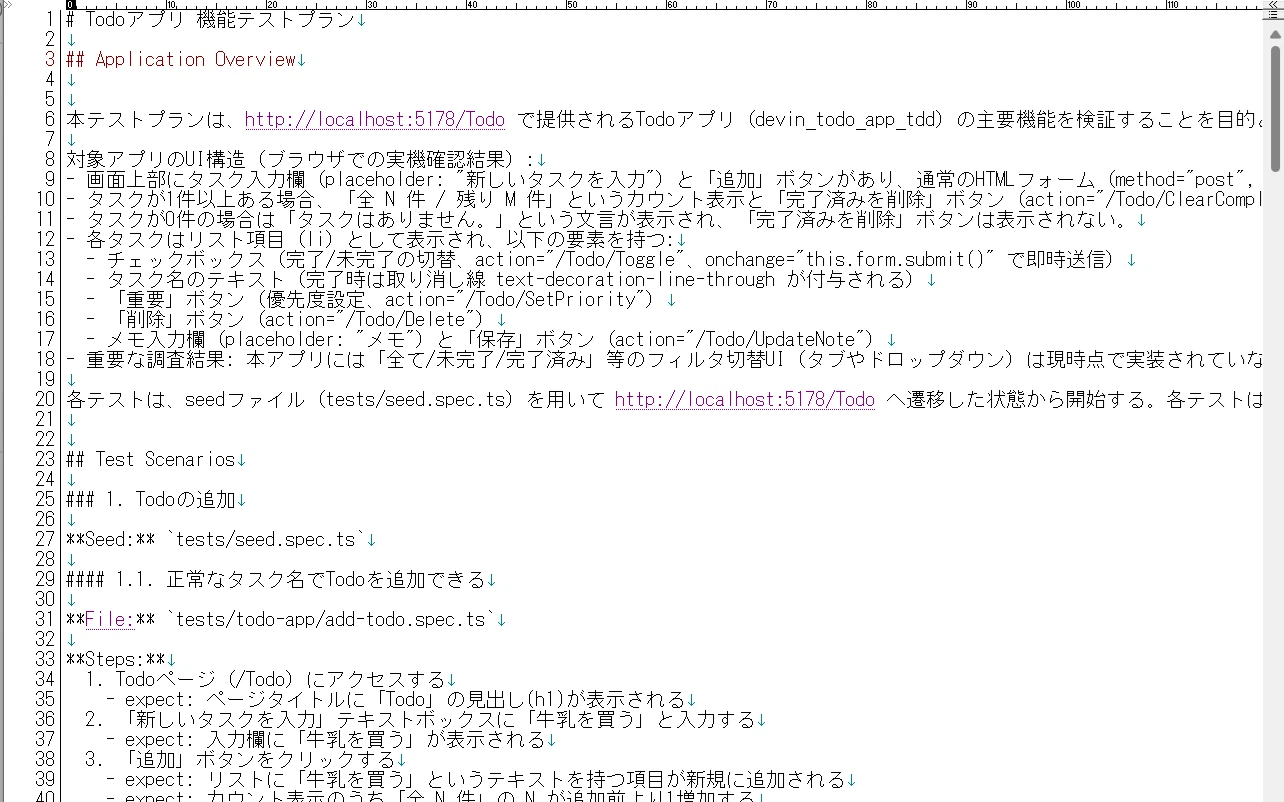
概要としては以下の通りです。
- Todoの追加 — 正常系/複数追加/空入力バリデーション/長文・特殊文字入力
- Todoの完了(トグル) — 完了⇔未完了、件数表示の確認
- Todoの削除 — 個別削除/完了済み一括削除/全件削除後の空状態
- フィルタの切替 — 現状UIに「全て/未完了/完了済み」を切り替える機能が実装されていないことが判明したため、未実装を確認するテスト+将来実装時用の保留テストとして構成
ここが個人的に一番驚いたポイントでして、依頼文では「意図的に」存在しない「フィルタ切替」のテストも頼んでいるのですが、Plannerは実際の画面を見て、その機能が存在しないことを正確に見抜き、存在しないボタンのセレクタを適当に捏造することなく「未実装」として扱いました。
画面を見ずに推測でコードを書く従来のAIアシスタントだと、実在しない要素へのアクセスを書いてしまいますが、これで「画面を見ながら判断する」ことを確認できました。
Generatorでテストコードを生成する
生成されたMarkdownの計画をもとに、テストコードを生成してもらいます。
このプラン(spec\todo-app.plan.md)からテストコードを生成して以下の3ファイル・11ケースが生成されました。
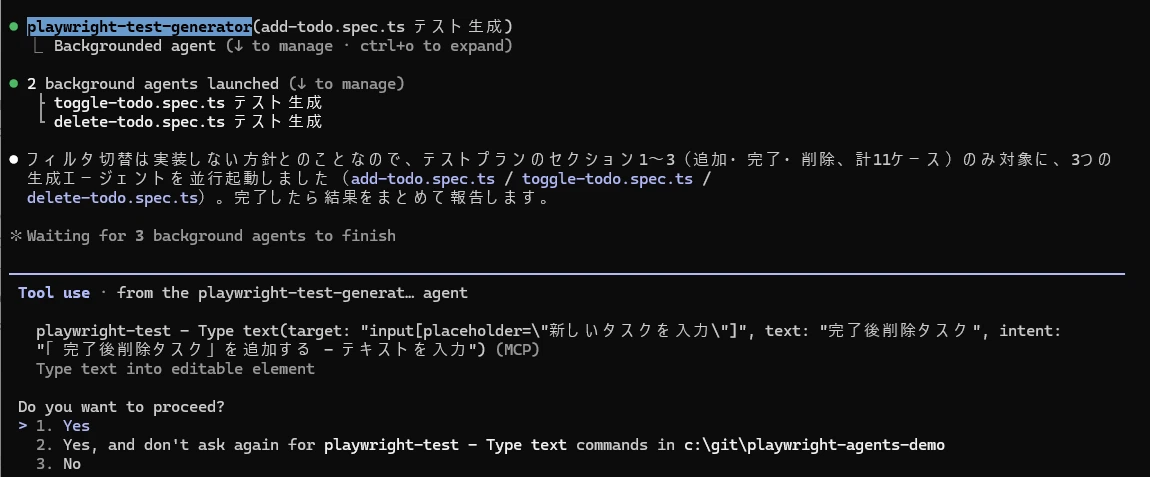
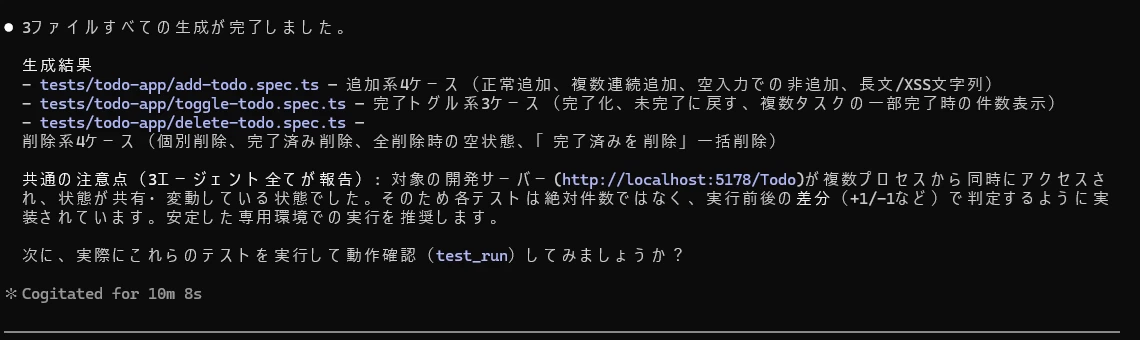
3ファイルは以下になります。
tests/todo-app/add-todo.spec.ts— 追加系4ケース(正常追加、複数連続追加、空入力での非追加、長文/XSS文字列)tests/todo-app/toggle-todo.spec.ts— 完了トグル系3ケース(完了化、未完了に戻す、複数タスクの一部完了時の件数表示)tests/todo-app/delete-todo.spec.ts— 削除系4ケース(個別削除、完了済み削除、全削除時の空状態、「完了済みを削除」一括削除)
Healerで自動修復する
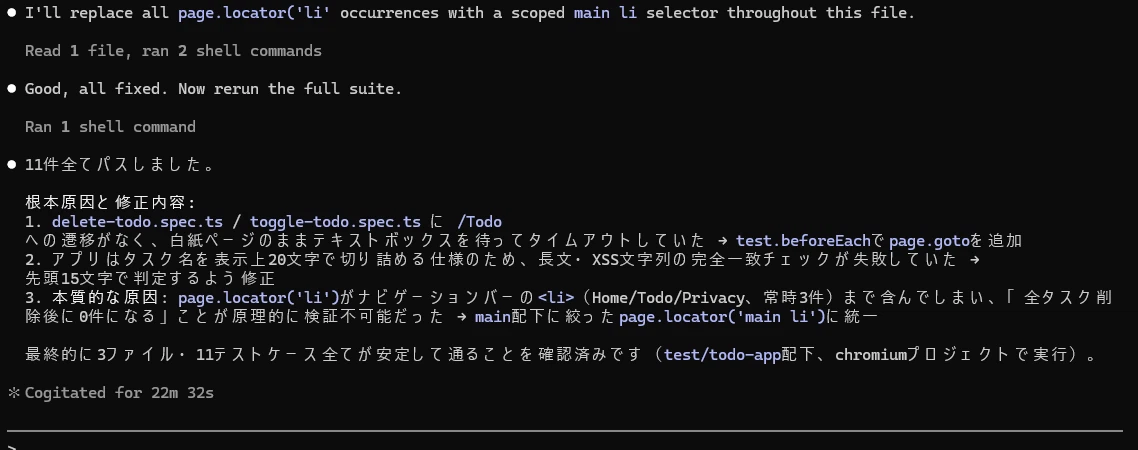
生成直後にテストを実行してもらったところ、いくつか失敗が出たため、そのままHealerに修復を任せました。最終的に11件全てパスするまで、以下の3つの原因を自律的に診断・修正しています。
delete-todo.spec.ts/toggle-todo.spec.tsに/Todoへの遷移がなく、白紙ページのままテキストボックスを待ってタイムアウトしていた →test.beforeEachでpage.gotoを追加- アプリはタスク名を表示上20文字で切り詰める仕様のため、長文・XSS文字列の完全一致チェックが失敗していた → 先頭15文字で判定するよう修正
- 本質的な原因:
page.locator('li')がナビゲーションバーの<li>(Home/Todo/Privacy、常時3件)まで含んでしまい、「全タスク削除後に0件になる」ことが原理的に検証不可能だった →main配下に絞ったpage.locator('main li')に統一
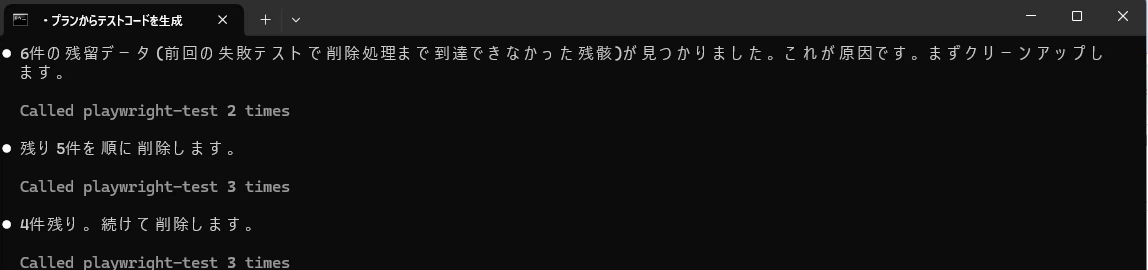
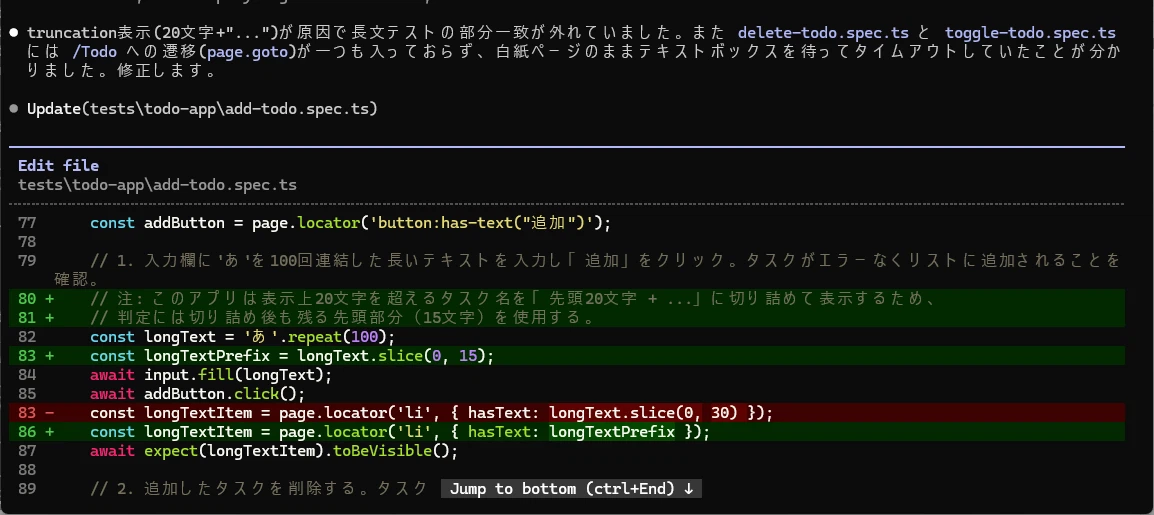
3つ目が特に興味深く、単なるロケータの打ち間違い修正ではなく、DOM構造の曖昧さ自体(テストの検証ロジックがそもそも成立しない設計ミス)を見抜いて直しています。
実行ログを見ると「実行→原因を考える→ファイルを編集→再実行」という一連の動作を、人間に一切確認を挟まず自分の判断だけで何周も繰り返していました。
これがいわゆる「エージェントループ」の実体で、Healerというサブエージェントに与えられた「テストが通るまで繰り返す」という終了条件に従って、Claude Code自体のループが自律的に回っていた形です。所要時間はPlannerの実行が約7分、Healerの実行が約22分でした。実際のAI実行(特に複数回のループを回すHealer)にはまとまった時間がかかる、というのは体感として押さえておきたいポイントです。
最終的に11件全てが安定して通ることを確認し、--headedで再実行して実際にブラウザが操作される様子も確認できました。
生成されたテストがかなり的を射たものでしたので、「本当に画面だけを見て判断しているのか、ソースコードを事前に読んでいるのではないか」という疑問が湧きまして、Claude Codeのツール呼び出し履歴を確認してみました。
結果、読んでいたファイルは自分が生成したテストファイル自身であり、ASP.NET Core側のソースコードを読んだ形跡はなさそうです。
Healerが見抜いた「20文字で切り詰められる仕様」も「ナビゲーションバーの<li>を巻き込んでいた」も、ブラウザに表示された内容とDOM構造を見れば説明がつく話で、やはりソースコードは「今回に関しては」読んでいないようです。
Test Agentsの精度向上
この精度向上の歴史(というほどでもないですが)を見てみると、Test Agents自体は2025年10月の登場し、1.60でのARIAスナップショットへの座標情報追加、1.62でのMCPサーバー標準バンドルなど、地道な改良が続いているようでして、それゆえの結果とか考えられます。
ただ体感の精度の高さとして、それ以上に裏側で動くAIモデル自体の進化の影響が大きいのかもしれません。Test Agentsは「画面を見せて、判断はAIモデルに任せる」という設計のため、精度の大部分は接続しているAIモデルの実力に依存します。つまり「Playwrightという土台の改良」と「その土台に乗っているAIモデルの進化」の掛け算で、今回体験したレベルの精度になっている、というのが実態に近いと思います。
仕様書の共有
今回は試しませんでしたが、公式ドキュメントによるとPlannerへの入力にはオプションで「PRD(Product Requirement Document)」を渡せるとのことです。
specs/とは別の場所に、シンプルなMarkdownでPRDを書きます(例:docs/todo-app-prd.md)。- Claude Codeへの依頼文で、このファイルを明示的に指定します。
planner を使って、docs/todo-app-prd.md の内容を踏まえたテストプランを作って。seed.spec.ts を使ってこのようにファイルパスを本文に書くだけで、Claude Codeが自動でそのファイルを読み込んでPlannerの判断材料に加えてくれます。画面には現れないビジネスルール(例:「完了済みタスクは編集不可」など)や、優先度、テスト対象外の範囲などをMarkdownで用意しておけば、それだけ判断材料が増えるということです。今回はUIだけで完結する小さなTodoアプリだったので不要でしたが、業務ロジックが複雑なアプリを対象にする場合は効果が大きそうです。次回以降で試してみたいと思います。
まとめ
「E2Eテストは遅い・外部APIに依存する・データ準備が必要」という性質はTest Agentsを使っても変わりません。AIに探索させても、ブラウザを起動して実際の画面を操作する構造自体は変わらないためです。Test Agentsが解決するのは実行速度の問題ではなく、「E2Eを書く・保守する人的コストが重い」という問題です。今回のHealerのように、UI変更でテストが壊れた際の修正を人間の代わりにこなしてくれる点が最大の価値だと感じました。
個人的な考えですが、E2Eは重要なシナリオに絞り、それ以外の網羅性はユニットテスト・APIテストで担保するという基本方針は変わらず、Test Agentsはその「絞られたE2E」を人間より安く速く作る・直すための道具、と位置づけるのが実態に近いと思います。
当社ネクストスケープはこのように生成AIをはじめとした新しい技術・知識を日々取り入れており、Webサイト、スマホアプリ、Hololensアプリの開発をはじめ、CMSを利用したサイトの新規構築やリニューアルなど、お客様のニーズに幅広く対応いたします。お困りのことがございましたら、いつでもお気軽にお問い合わせください。
(以下当社お問合せフォーム)
当社では一緒に働いてくれる仲間を募集しています。是非以下のサイトよりお申込みください。
