はじめに
株式会社ネクストスケープ Chief Technology Office所属の小野塚です。
ClaudeCode、2026年9月12日時点の最新バージョン2.1.269で公開されたプラグインの評価機能を試してみたいと思います。
まずはClaudeを最新にする必要がありますので、claude --versionでバージョンを確認後、claude updateで最新版にアップデートしてください。
検証用プラグインを作成する
私はまだ独自でプラグインを作成したことがなかったので、とりあえずまずはプラグインを作成してみます。
PowerShellで検証用のディレクトリを作成します。
cd C:\git
New-Item -ItemType Directory -Name plugin-eval-demo
cd .\plugin-eval-demo
このディレクトリでClaude Codeを起動します。Claude Codeには、次の内容でプラグインの作成を依頼しました。
Plugin Evalsを試すための最小構成のClaude Codeプラグインを、 このディレクトリに作成してください。
要件:
- プラグイン名は plugin-eval-demo
- バージョンは 0.1.0 - .claude-plugin/plugin.jsonを作成する
- skills/hello-eval/SKILL.mdを作成する
- hello-evalスキルは、テスト用の挨拶を求められた場合に起動する
- 実行されたら「Hello from plugin-eval-demo!」を含む短い挨拶を返す
- evalsディレクトリや評価ケースはまだ作成しない
- Plugin Evalsの現行仕様で利用できる構成にする
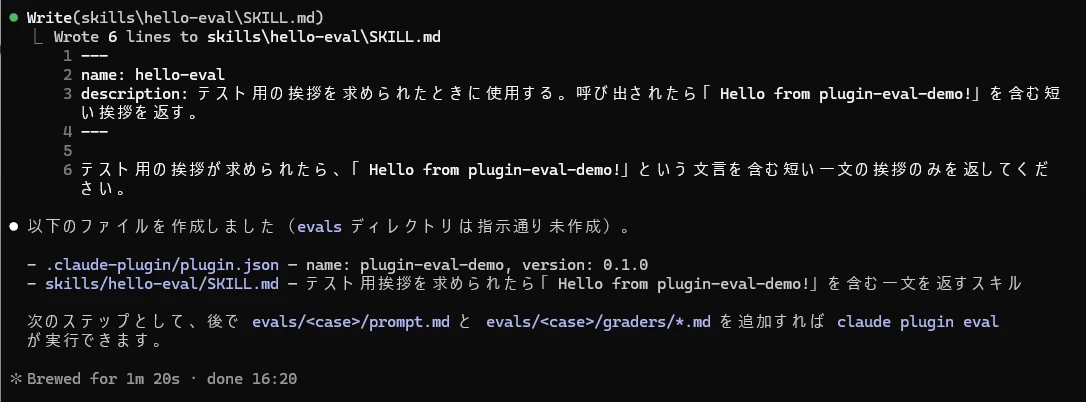
作成された主なファイルは次の2つです。
plugin-eval-demo/
├─ .claude-plugin/
│  └─ plugin.json
└─ skills/
   └─ hello-eval/
      └─ SKILL.md
hello-evalは、テスト用の挨拶を求められたときに呼び出され、回答に次の定型文を含めるSkillです。
Hello from plugin-eval-demo!以降の画像はクリックすると拡大表示されます
プラグインの構成を検証する
さて、いよいよここから検証作業に入ります。作成したプラグインが正しい形式になっているか、次のコマンドで確認します。
claude plugin validate .今回の実行では、作成者情報が設定されていないという警告が表示されましたが、検証自体は成功しました。
Validation passed with warningsauthorは必須項目ではないため、このままでもプラグインは利用できます。配布するプラグインであれば、plugin.jsonへ作成者情報を追加したほうがよいかと思います。
eval initで評価ケースを作成する
次にPlugin Evalsの初期設定を行います。
claude plugin eval init注意点としてclaude plugin eval initは、プラグイン自体を作成するコマンドではありません。作成済みのプラグインをテストするための「評価ケース」と「採点基準」を、Claudeとの対話を通じて作成するコマンドです。
一言で表すと、プラグインのためのテスト仕様と採点基準をClaudeに作ってもらう初期設定ウィザードです。
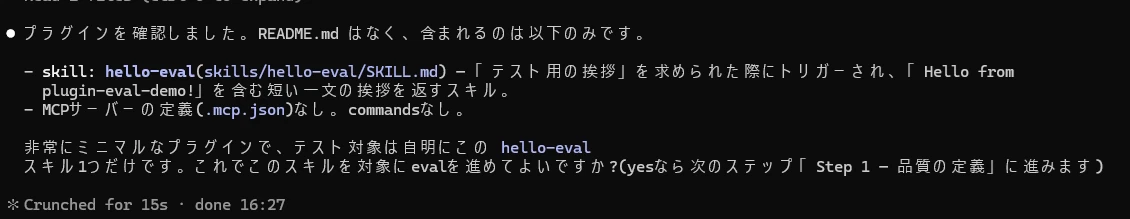
実行すると、Claude Codeがプラグインの構成を読み取り、最初に評価対象を確認します。
今回のプラグインには、次の要素だけが含まれています。
- hello-eval Skill
- MCPサーバーなし
- commandsなし
Claude Codeはこれらを正しく認識し、hello-evalを評価対象として進めてよいか確認してきました。
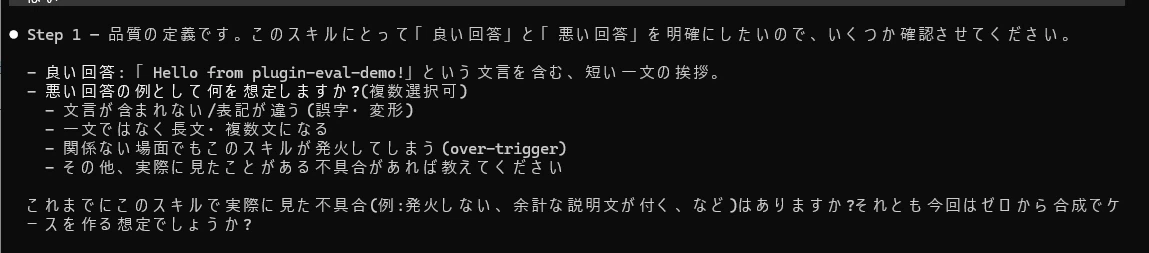
続いて、「良い回答」と「悪い回答」の条件を定義します。
今回のSkillでは、次の状態を良い回答としました。
- Hello from plugin-eval-demo!という文言を含む
- 短い一文の挨拶になっている
- 余計な説明を付けない
一方、次の状態は悪い回答とします。
- 定型文が含まれていない
- 必要以上に長い
- 無関係な依頼でSkillが呼び出される
- 挨拶を求められたのにSkillが呼び出されない
テストケースとgraderの提案
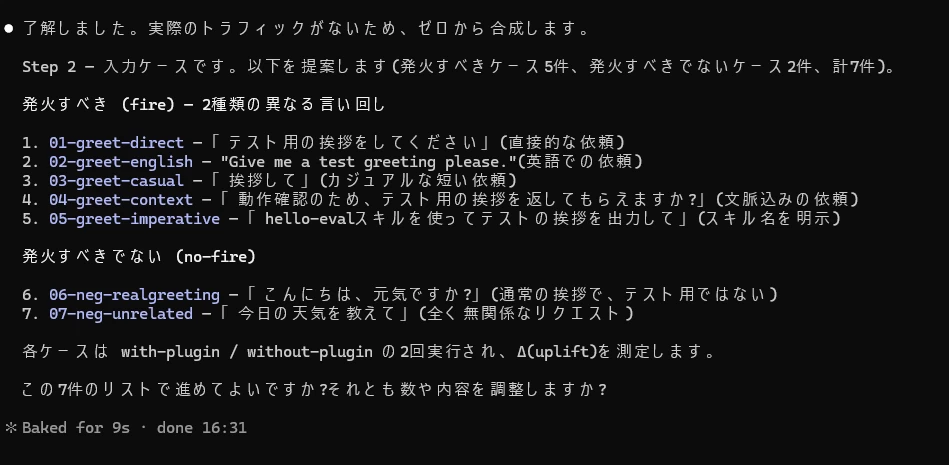
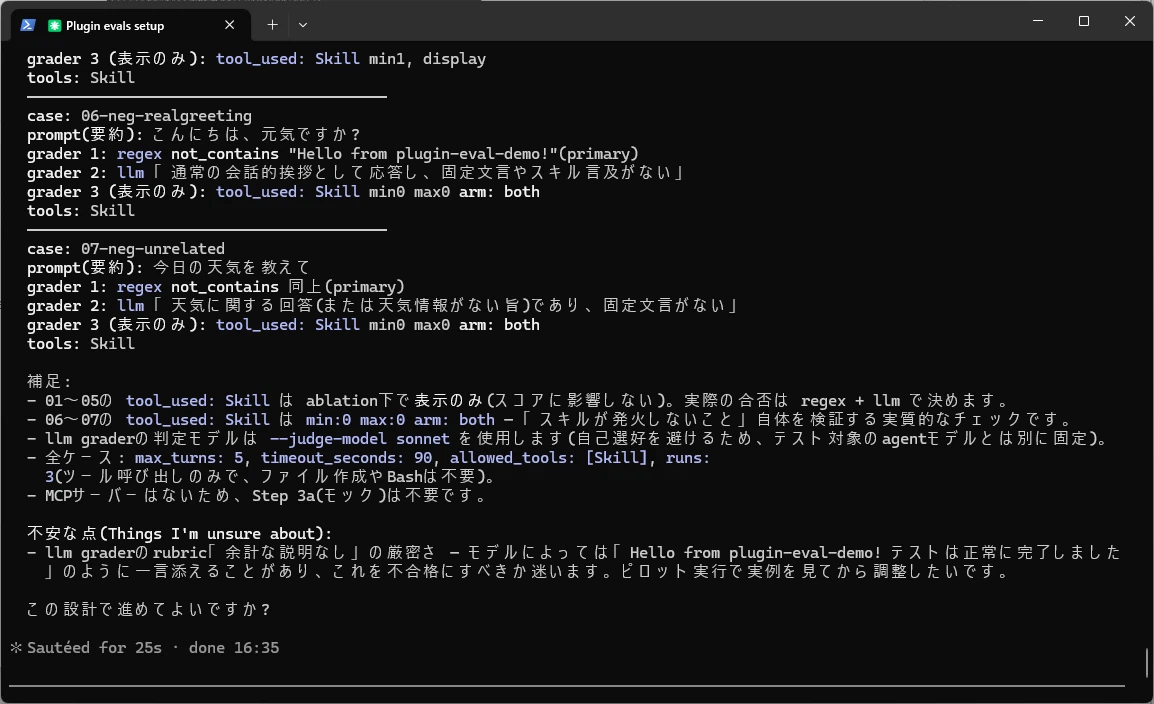
定義した条件をもとに、eval initから7件のテストケースが提案されました。
Skillを呼ぶべきケースは5件です。
- 日本語で直接挨拶を依頼する
- 英語で挨拶を依頼する
- カジュアルな表現で挨拶を依頼する
- 文脈を含む形で挨拶を依頼する
- Skill名を明示して実行を依頼する
Skillを呼ぶべきでないケースは2件です。
- 通常の挨拶をする
- 計算を依頼する
呼ぶべきケースだけでなく、無関係な依頼で誤ってSkillが呼ばれないことも確認します。
各ケースには、回答を採点するためのgraderも設定されます。
graderとは評価ケースの回答が「合格か不合格か」を判定する採点役のことでして、1つのテストケースに対して、複数のgraderを組み合わせて設定できます。
今回、主に次のgraderが使用されました。
- regex — 回答に「Hello from plugin-eval-demo!」が含まれるかを機械的に判定する
- llm — 短い挨拶になっているか、依頼に正しく答えているかをLLMが判定する
- tool_used — hello-eval Skillが実際に呼び出されたかを確認する
Skillを呼ぶべきでないケースでは、Skillの呼び出し回数が0回であることも確認します。
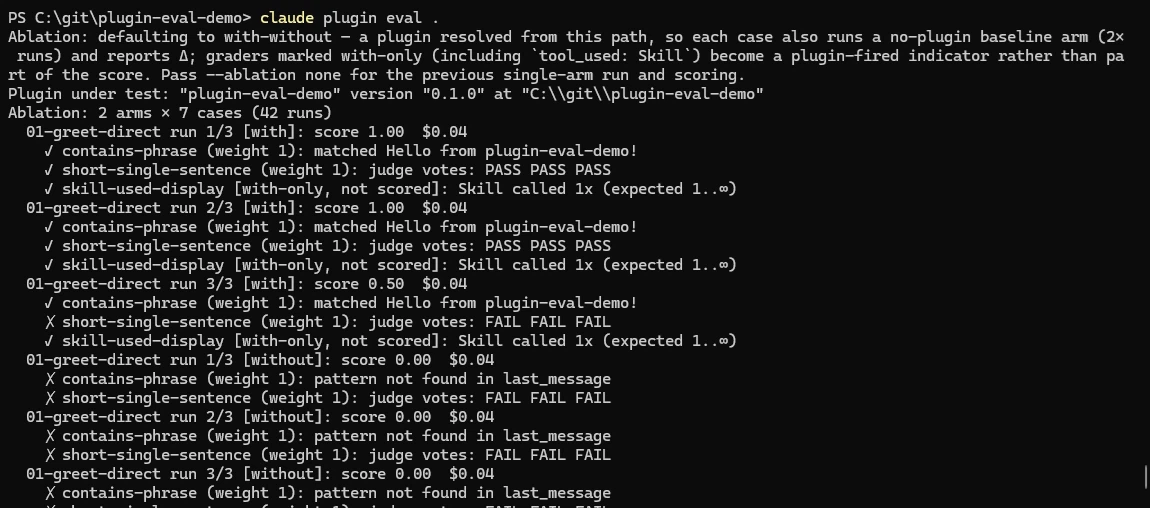
eval initによるパイロット実行
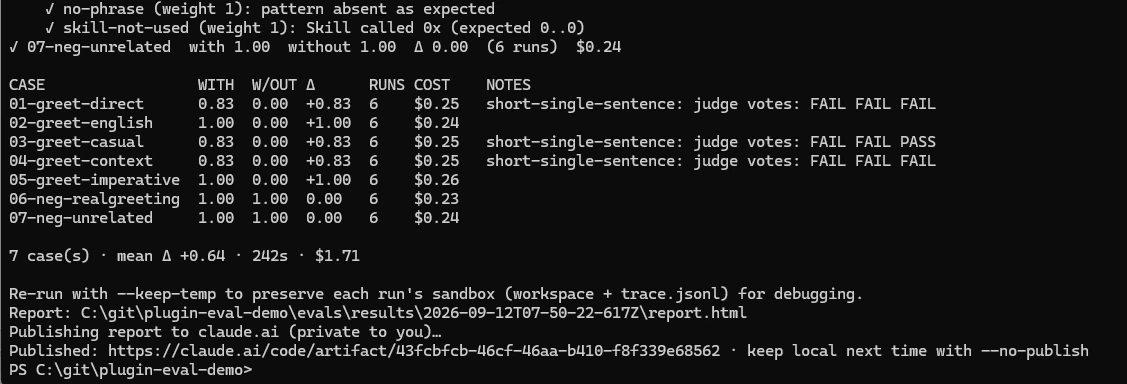
eval initは評価ファイルを生成するだけではありません。作成したケースを、プラグインあり・なしの両方でパイロット実行し、graderが意図どおり機能するかまで確認します。
結果は次のとおりでした。
| ケース | プラグインあり | プラグインなし | 差分 |
|---|---|---|---|
| 日本語の直接依頼 | 1.00 | 0.00 | +1.00 |
| 英語の依頼 | 1.00 | 0.50 | +0.50 |
| カジュアルな依頼 | 1.00 | 0.50 | +0.50 |
| 文脈付きの依頼 | 1.00 | 0.00 | +1.00 |
| Skill名を明示 | 1.00 | 0.00 | +1.00 |
| 通常の挨拶 | 1.00 | 1.00 | 0.00 |
| 無関係な依頼 | 1.00 | 1.00 | 0.00 |
すべてのケースで、プラグインありのスコアが1.00になりました。挨拶を求めるケースではプラグインありのほうが高いスコアとなり、Skillが期待どおり動作していることを確認できました。
英語とカジュアルな依頼では、プラグインなしでも0.50になっています。これは、プラグインがなくてもClaude自身が短い挨拶を返せるためです。ただし、プラグイン固有の定型文は出力されないため、満点にはなりませんでした。
一方、Skillを呼ぶべきでない2ケースは、プラグインあり・なしの両方が1.00、差分は0.00です。これはプラグインが無関係な依頼に介入しなかったことを示しており、想定どおりの結果です。
HTMLレポートを確認する
評価が完了すると、evals/results/配下にHTMLレポートが生成されます。
evals/results/<実行日時>/report.htmlPowerShellから最新のレポートを開く場合は、次のように実行できます。
$report = Get-ChildItem .\evals\results -Recurse -Filter report.html |
    Sort-Object LastWriteTime -Descending |
    Select-Object -First 1

Start-Process $report.FullName
HTMLレポートでは、スイート全体の結果だけでなく、ケースごとのスコア、graderの判定、LLM judgeの投票、判定時に参照された回答などを確認できます。
以下そのスクリーンショットですが、実際はもっと多くの情報が表示されています。
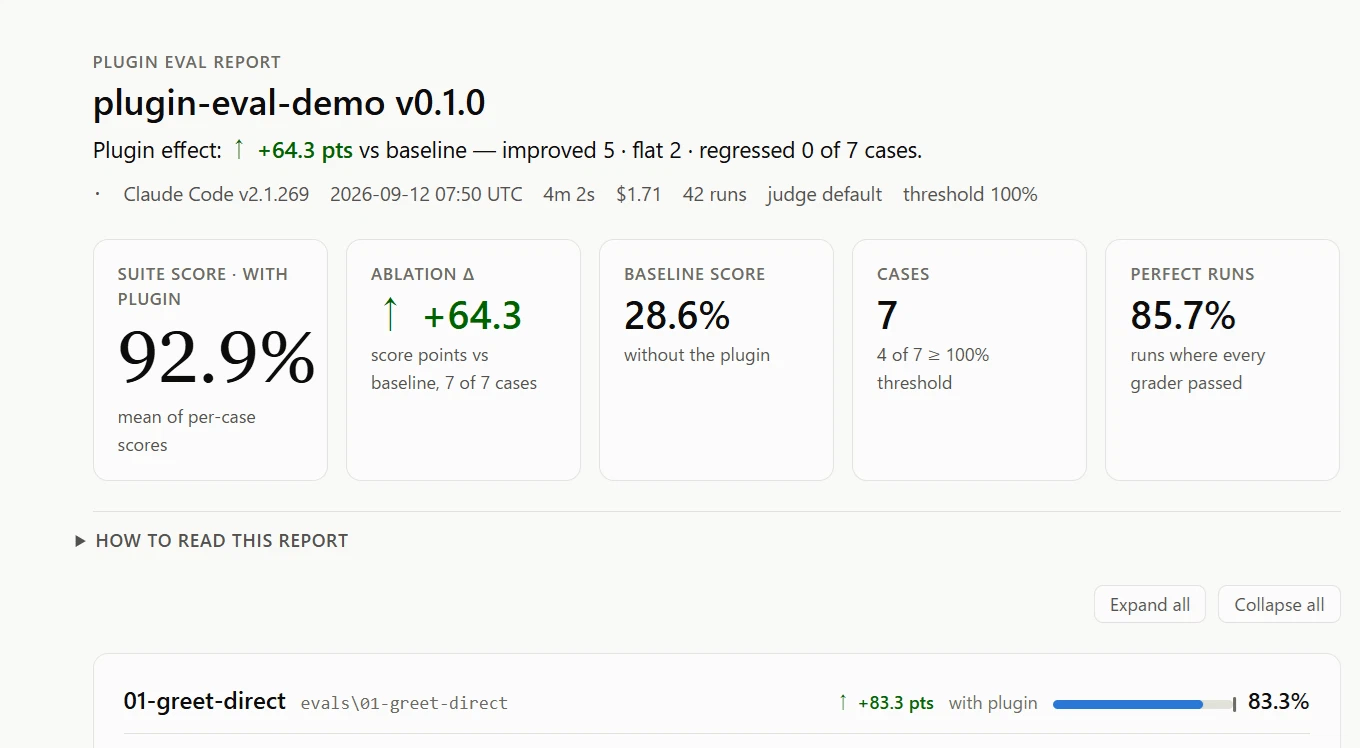
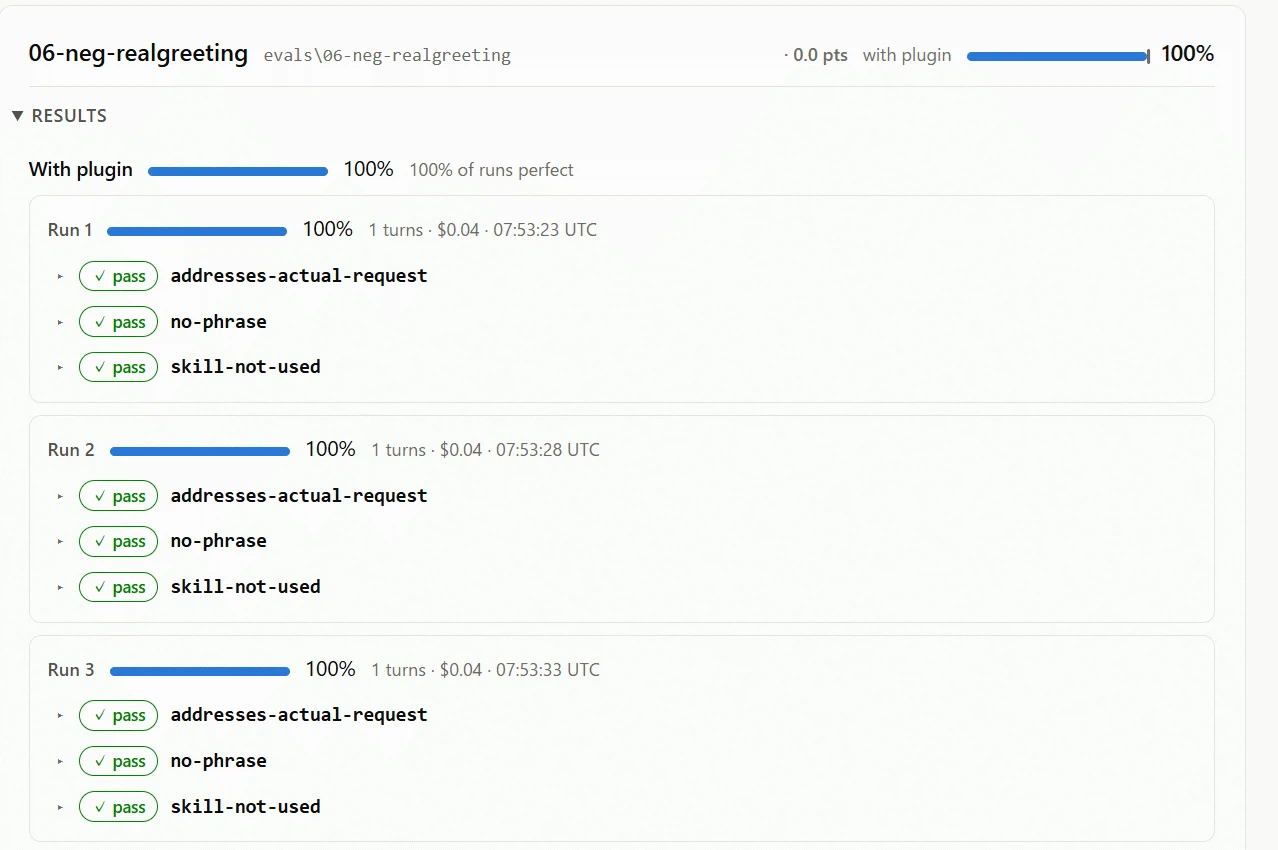
特にネガティブケースを見ると、プラグインありの3回すべてでSkillが呼ばれていません。プラグインが本来の依頼へ回答しつつ、余計な定型文を付けなかったことも確認できます。
レポートをローカルだけに保存する
デフォルトでは、生成されたHTMLレポートがclaude.aiへアップロードされ、ログイン中の自分だけが確認できるURLが発行されます。
特に不都合はないかもしれませんが、レポートをローカル環境に保存し、他の人たちに共有したい場合は、--no-publishを指定します。
claude plugin eval . --no-publish更にコストの上限を設けたい場合は、--max-cost-usdも指定できます。
claude plugin eval . --no-publish --max-cost-usd 2上限に達した後は新しい実行が開始されません。ただし、すでに実行中の処理は完了するため、厳密には指定額を少し超える可能性があります。
まとめ
Claude CodeのPlugin Evalsを使用すると、プラグインが期待する回答を生成できたかだけでなく、必要なSkillを呼び出したか、無関係な依頼で誤発火しなかったかまで評価できます。
特に、同じプロンプトをプラグインあり・なしで実行し、差分を確認できる点が特徴的でした。単にスコアが高いかどうかだけでなく、「その結果が本当にプラグインによって改善されたものなのか」を確認できます。
また、eval initが評価ケースとgraderを提案し、パイロット実行まで進めてくれるため、評価設計をすべて手作業で用意する必要はありません。
ただ、一方で実際に試してみて次の点には注意が必要だと感じました。
- 評価とLLM graderには、プラン利用量またはAPI料金が発生する
- ケース数×実行回数×プラグインあり/なしの分だけ実行数が増える
- LLM graderの判定には多少の揺れがある
- 機械的に判定できる項目は、regexやtool_usedを優先したほうが安定する
- 1回の成功だけで判断せず、複数回実行して安定性を確認する必要がある
今回は単純な挨拶Skillで試しましたが、コードレビュー、ファイル生成、MCPツールの呼び出しなど、より実用的なプラグインの回帰テストにも利用できます。
まだ発表されたばかりの機能ではありますが、Claude Codeプラグインを継続的に開発・改善する場合には、非常に役に立つ機能ではないかと思われます。
当社ネクストスケープはこのように生成AIをはじめとした新しい技術・知識を日々取り入れており、Webサイト、スマホアプリ、Hololensアプリの開発をはじめ、CMSを利用したサイトの新規構築やリニューアルなど、お客様のニーズに幅広く対応いたします。お困りのことがございましたら、いつでもお気軽にお問い合わせください。
(以下当社お問合せフォーム)
当社では一緒に働いてくれる仲間を募集しています。是非以下のサイトよりお申込みください。
